 CueBuddy
 휴대폰으로 스캔해 다운로드
카메라 앞에서 말할 때 마주치는 핵심 딜레마는 한 줄로 정리할 수 있어요. 정확함과 자연스러움, 두 가지를 동시에 하려고 한다는 것.
스크립트 없이: 자연스럽지만 부정확. 읽으면서: 정확하지만 딱딱. 이 모순이 풀리지 않는 한, 토킹헤드 콘텐츠의 효율은 정체됩니다.
AI 텔레프롬프터와 일반 텔레프롬프터의 차이
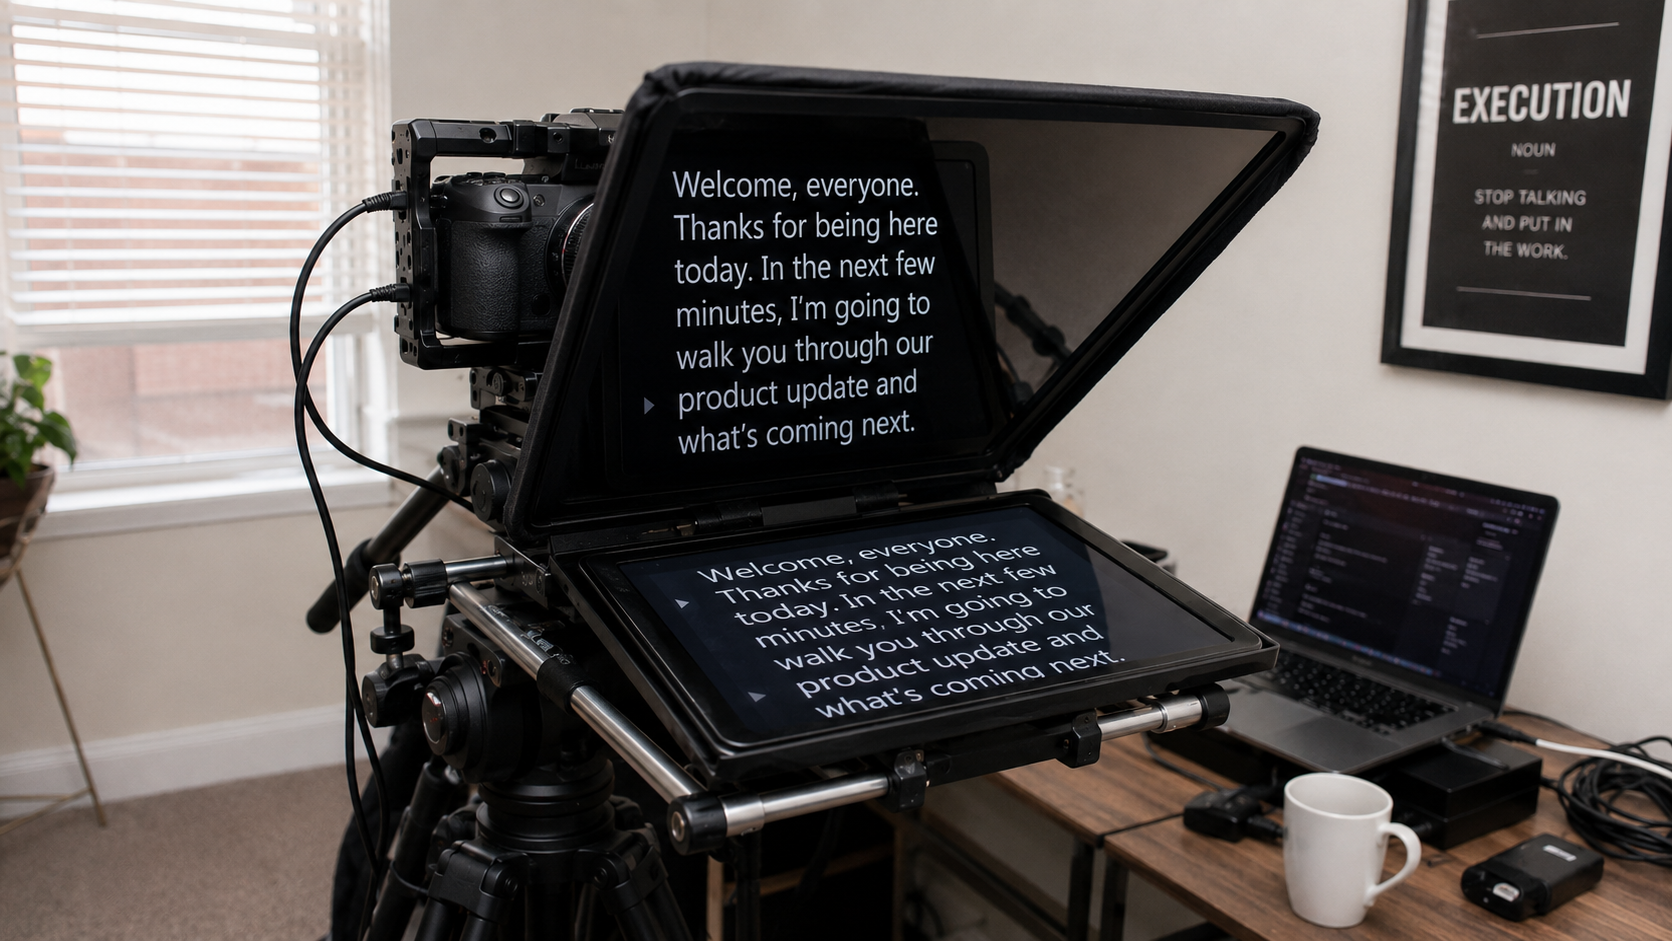
많은 분들이 "AI 텔레프롬프터"라고 하면 그냥 화면에 글자 띄우는 거라고 생각해요. 메모 앱이랑 뭐가 다르냐고요.
차이는 음성 추적입니다.
기존 텔레프롬프터는 눈이 멀었어요. 설정한 속도로 그냥 스크롤하죠. 본인이 뭘 말하는지, 스크립트 어디쯤인지, 막혔는지 같은 건 알 길이 없어요.
AI 텔레프롬프터는 듣습니다. CueBuddy는 아이폰의 로컬 음성 인식 모델을 사용합니다:
- Apple Speech framework의 인식 결과 사용
- 음성 추종: 기기·OS·언어·설치된 리소스에 따라 기기 내 지원 여부가 다름
- 실제 촬영 환경에서 사전 테스트 필요
- 데이터 처리는 현재 개인정보 처리방침 참고
워크플로우: 첫 마디를 말함 → 앱이 인식 → 스크립트에서 찾음 → 초록색 하이라이트 → 계속 말함 → 하이라이트가 따라옴 → 빨라지면 스크롤 빨라짐 → 멈추면 스크롤 멈춤 → 다시 하려고 앞부분으로 점프 → 하이라이트도 따라 이동.
버튼 0. 파라미터 조정 0. 본인이 말하면 프롬프터가 따라옵니다.
세 가지 핵심 변화
변화 1: 외우는 사람에서, 전하는 사람으로
AI 텔레프롬프터가 없으면, 촬영 중에 머릿속은 이렇게 돌아갑니다: "다음 뭐지? 까먹지 마. 까먹지 마." 온 신경을 회수에 쏟아붓고, 표현력이든 톤이든 제스처든 사생아처럼 방치되죠. 그나마 그것도 얼마 안 됩니다.
AI 텔레프롬프터를 쓰면 외울 게 없어요. 글자는 화면에 있고, AI가 위치를 추적합니다. 뇌는 딱 한 가지에 집중할 수 있어요. 이걸 잘 말하는 법. 억양, 멈춤, 강조, 제스처. 마침내 충분한 두뇌 대역폭을 얻습니다.
변화 2: 촬영이 도박에서 프로세스로
프롬프터가 없으면, 촬영은 장애물 경주처럼 느껴져요. 몇 번을 찍어야 할지 모릅니다. 그 불확실성이 에너지를 갉아먹죠.
스크립트를 준비한 뒤 CueBuddy로 촬영하고 필요하면 다시 촬영합니다. 필요한 시도 횟수는 스크립트, 숙련도, 환경에 따라 다릅니다.
변화 3: 즉흥이 안전해짐
스크립트와 즉흥 발언의 비율은 내용과 화자에 따라 다르며 공통된 고정 비율은 없습니다.
작업 흐름의 변화
| 지표 | 변화 |
|---|---|
| 촬영 시간 | 스크립트·기기·숙련도에 따라 다름 |
| 후반 작업 | 촬영 후 편집과 확인은 여전히 필요함 |
| 촬영 마인드셋 | "긴장 풀어야지"에서 "스크립트 다 썼다, 가자"로 |
효율은 결과지 목표가 아니에요. 진짜 변화는 촬영이 재밌어진다는 거예요. 책을 넘겨주는 인내심 좋은 파트너가 옆에 있는 느낌. 그건 효율이 아니라 편안함입니다.
현재 CueBuddy iPhone/iPad의 기기 내 인식 경로는 지원 기기, OS, 언어 및 설치된 리소스가 필요합니다. Mac은 별도 확인이 필요합니다. 웹 버전의 브라우저 음성 서비스는 온라인으로 처리할 수 있습니다. 중요한 촬영 전에 실제 기기에서 테스트하세요.
먼저 무료 온라인 프롬프터로 테스트하세요
스크립트, 말하기 리듬, 대사 기억, 촬영 흐름을 정리하려면 브라우저 프롬프터에 원고를 넣어 먼저 테스트하세요. 더 완성된 모바일 촬영 흐름이 필요하면 CueBuddy 앱을 사용하면 됩니다.
CueBuddy로 다음 촬영을 시작하세요
핵심 프롬프터 기능을 무료로 먼저 체험한 뒤, 더 강한 녹화·촬영 워크플로우가 필요하면 CueBuddy를 사용하세요.